Věda by měla být v první řadě hledáním pravdy a odpovědí na otázky, které pokládá okolní svět. Ale i jí dělají obyčejní smrtelníci se svými slabostmi a neřestmi a tak bohužel i ve vědě, která ze své podstaty volá po křišťálové čistotě, dochází k podvodům..
Nový systém využívající umělou inteligenci prověřil miliony vědeckých studií o rakovině a objevil stovky tisíc publikací, které nesou známky práce takzvaných paper mills. Výsledky tak naznačují, že problém falešného výzkumu může být mnohem rozsáhlejší, než si vědci dosud připouštěli.
Věda stojí na jednoduchém principu: každý nový objev musí být podložený důkazy a ověřitelný dalšími odborníky. Právě díky tomu se medicína, fyzika nebo biologie a samozřejmě i další obory posouvají kupředu.
Co se ale stane, když se do odborných časopisů začnou ve velkém dostávat studie, které žádný skutečný výzkum nepopisují? A zdaleka nejde jen o akademický problém. V případě onkologie mohou chybné nebo zcela smyšlené práce ovlivnit další výzkum, vývoj nových léků i rozhodování lékařů, a ve výsledku tak zpomalit hledání účinnější léčby pro miliony pacientů a tím tak ničit životy.
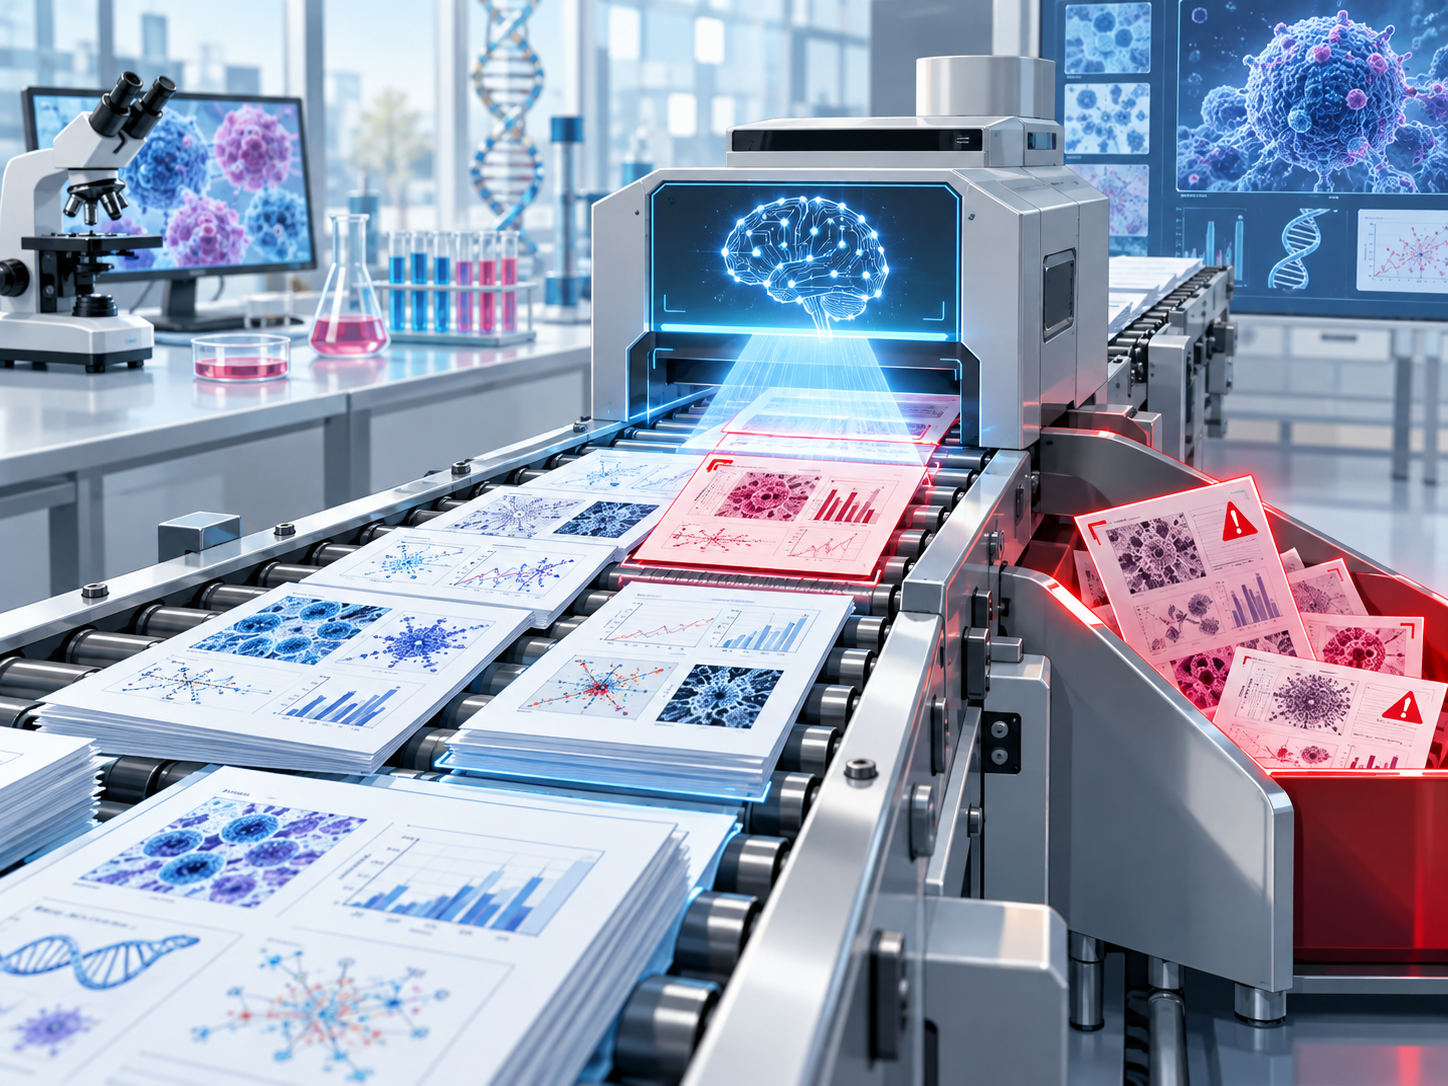
Právě na tento problém se zaměřili vědci z australské Queensland University of Technology. Vyvinuli systém využívající umělou inteligenci, který analyzoval 2,6 milionu vědeckých článků o rakovině publikovaných mezi lety 1999 a 2024. Výsledky jsou znepokojivé, protože algoritmus označil více než 250 000 studií jako podezřelé z toho, že vznikly v takzvaných paper mills, tedy jakých si farmách na falešné vědecké práce.
Přestože nejde o definitivní důkaz podvodu, rozsah problému překvapil i samotné autory výzkumu. „Paper mills jsou společnosti, které prodávají falešné nebo nekvalitní vědecké studie. Produkují výzkum doslova v průmyslovém měřítku a naše zjištění naznačují, že problém v oblasti výzkumu rakoviny je mnohem větší, než si většina lidí uvědomovala,“ říká vedoucí výzkumného týmu Adrian Barnett z Queensland University of Technology.
Navenek nabízejí pomoc s přípravou vědeckých článků nebo statistickým zpracováním dat, avšak ve skutečnosti však takzvané paper mills fungují jako výrobní linky na falešné vědecké studie. Za úplatu, která bývá nemalá, dokážou vytvořit celý článek a to od smyšlených experimentů a upravených grafů až po vymyšlené výsledky a zároveň zajistit jeho publikování v odborném časopise.
Zákazník pak získá publikaci, kterou může uvést ve svém životopise, aniž by skutečný výzkum vůbec provedl. Důvod, proč podobný byznys existuje, je jednoduchý. Akademická kariéra je dnes ve velké míře postavena na počtu publikovaných článků a vědci podle nich získávají granty, povyšují na vyšší pozice, budují prestiž svých pracovišť a univerzity je využívají při hodnocení své vědecké výkonnosti.
Známé pravidlo „publish or perish“ (publikuj, nebo zanikni) tak vytváří obrovský tlak zejména na mladé výzkumníky.
Nejde přitom o okrajový problém. V posledních letech museli vydavatelé stáhnout tisíce vědeckých článků poté, co se ukázalo, že obsahují zmanipulované obrázky, smyšlená data nebo prošly falešným recenzním řízením.
Jen nakladatelství Wiley a Hindawi v roce 2023 stáhla přes osm tisíc publikací právě kvůli aktivitám paper mills. Objevily se také případy, kdy organizované skupiny nabízely autorství již hotových článků za desítky tisíc dolarů nebo manipulovaly systém recenzního řízení pomocí smyšlených identit odborných hodnotitelů.
Aby zjistili, jak rozsáhlý problém ve skutečnosti je, nechali vědci svůj algoritmus analyzovat přibližně 2,6 milionu odborných článků o rakovině publikovaných mezi roky 1999 až 2024. Nešlo přitom o hledání klasických plagiátů ani doslovně zkopírovaných pasáží, badatelé chtěli odhalit mnohem nenápadnější znaky, které mohou prozrazovat průmyslově vyráběné vědecké práce.
Základem systému se stal jazykový model BERT, jeden z předchůdců dnešních velkých jazykových modelů. Výzkumníci jej natrénovali na stovkách již stažených studií, u nichž bylo prokázáno, že pocházejí z paper mills.
Algoritmus se tak naučil rozpoznávat opakující se slovní obraty, stereotypní strukturu článků i další jazykové vzorce, které jsou pro podobné publikace typické.
Právě tím se nový přístup zásadně liší od běžných antiplagiátorských programů. Ty porovnávají shodu textů a hledají doslovně převzaté pasáže, zatímco nový systém se zaměřuje na styl psaní, způsob argumentace a další charakteristiky, které mohou naznačovat společný původ článků.
„Nejspíš spoléhají na šablony, které lze odhalit pomocí velkých jazykových modelů analyzujících vzorce v textech,“ vysvětluje Adrian Barnett. Při testování na známých případech dosáhl algoritmus přesnosti přibližně 91 procent a sám Barnett jej proto přirovnává ke „spamovému filtru pro vědu“, který dokáže upozornit na podezřelé studie dříve, než se stanou základem dalšího výzkumu.
Přestože číslo přesahující 250 000 podezřelých studií působí alarmujícím dojmem, samotní autoři výzkumu nabádají k opatrnosti. Algoritmus totiž neurčuje, zda je konkrétní článek podvodný, jen upozorňuje na práce, které vykazují stejné jazykové a strukturální znaky jako dříve odhalené publikace pocházející z paper mills.
Podezřelý článek navíc nemusí být automaticky falešný. Některé práce mohou být pouze nekvalitně napsané, mohou obsahovat metodické chyby nebo pocházet od autorů, pro které není angličtina mateřským jazykem.
Skutečný vědecký podvod znamená něco jiného, tedy vědomé falšování dat, vymýšlení experimentů nebo manipulaci s výsledky za účelem jejich publikování.
Právě proto by podle autorů studie měla umělá inteligence sloužit především jako pomocník editorů a recenzentů. Na podezřelé práce upozorní, ale konečné rozhodnutí musí vždy udělat člověk, který posoudí metodiku, data i věrohodnost celé studie.
„Náš model není navržen tak, aby obviňoval jednotlivé autory. Jeho úkolem je upozornit na články, které si zaslouží důkladnější prověření,“ zdůrazňuje Adrian Barnett. Výzkumníci zároveň upozorňují, že bez podobných nástrojů bude stále obtížnější udržet krok s rostoucím množstvím vědeckých publikací.
Jen v oblasti onkologického výzkumu totiž každoročně vycházejí desetitisíce nových studií, které už lidské týmy nedokážou všechny pečlivě zkontrolovat.
Vědecké podvody posledních letech
Andrew Wakefield (1998) – Britský lékař publikoval studii, která údajně prokazovala souvislost mezi vakcínou MMR a autismem. Později se ukázalo, že data byla zmanipulovaná a autor jednal ve střetu zájmů. Článek byl stažen a Wakefield přišel o lékařskou licenci.
Hwang Woo-suk (2004–2005) – Jihokorejský biolog tvrdil, že jako první na světě naklonoval lidské embryonální kmenové buňky. Vyšetřování však odhalilo zfalšovaná data i neetické získávání lidských vajíček. Studie byly staženy.
Jan Hendrik Schön (2002) – Mladý fyzik z Bell Labs publikoval převratné práce o organických polovodičích. Později se ukázalo, že opakovaně používal stejná experimentální data pro různé studie a řadu výsledků si jednoduše vymyslel. Staženo bylo více než 20 jeho článků.
Yoshitaka Fujii – Japonský anesteziolog se stal nechvalně proslulým rekordmanem ve falšování vědeckých dat. Z odborných časopisů bylo staženo více než 180 jeho studií, převážně kvůli smyšleným výsledkům klinických výzkumů.
Didier Raoult (od roku 2020) – Francouzský mikrobiolog během pandemie covidu-19 prosazoval léčbu hydroxychlorochinem. Některé jeho studie byly později staženy nebo se dostaly pod ostrou kritiku kvůli závažným metodologickým a etickým nedostatkům.
Kauza znovu otevřela debatu o kvalitě recenzního řízení v prestižních časopisech.